Microsoft presentó Maia 300, su tercer chip propio de IA, y desde 2027 lo convertirá en el sistema principal de inferencia de sus productos con despliegues de varios gigavatios
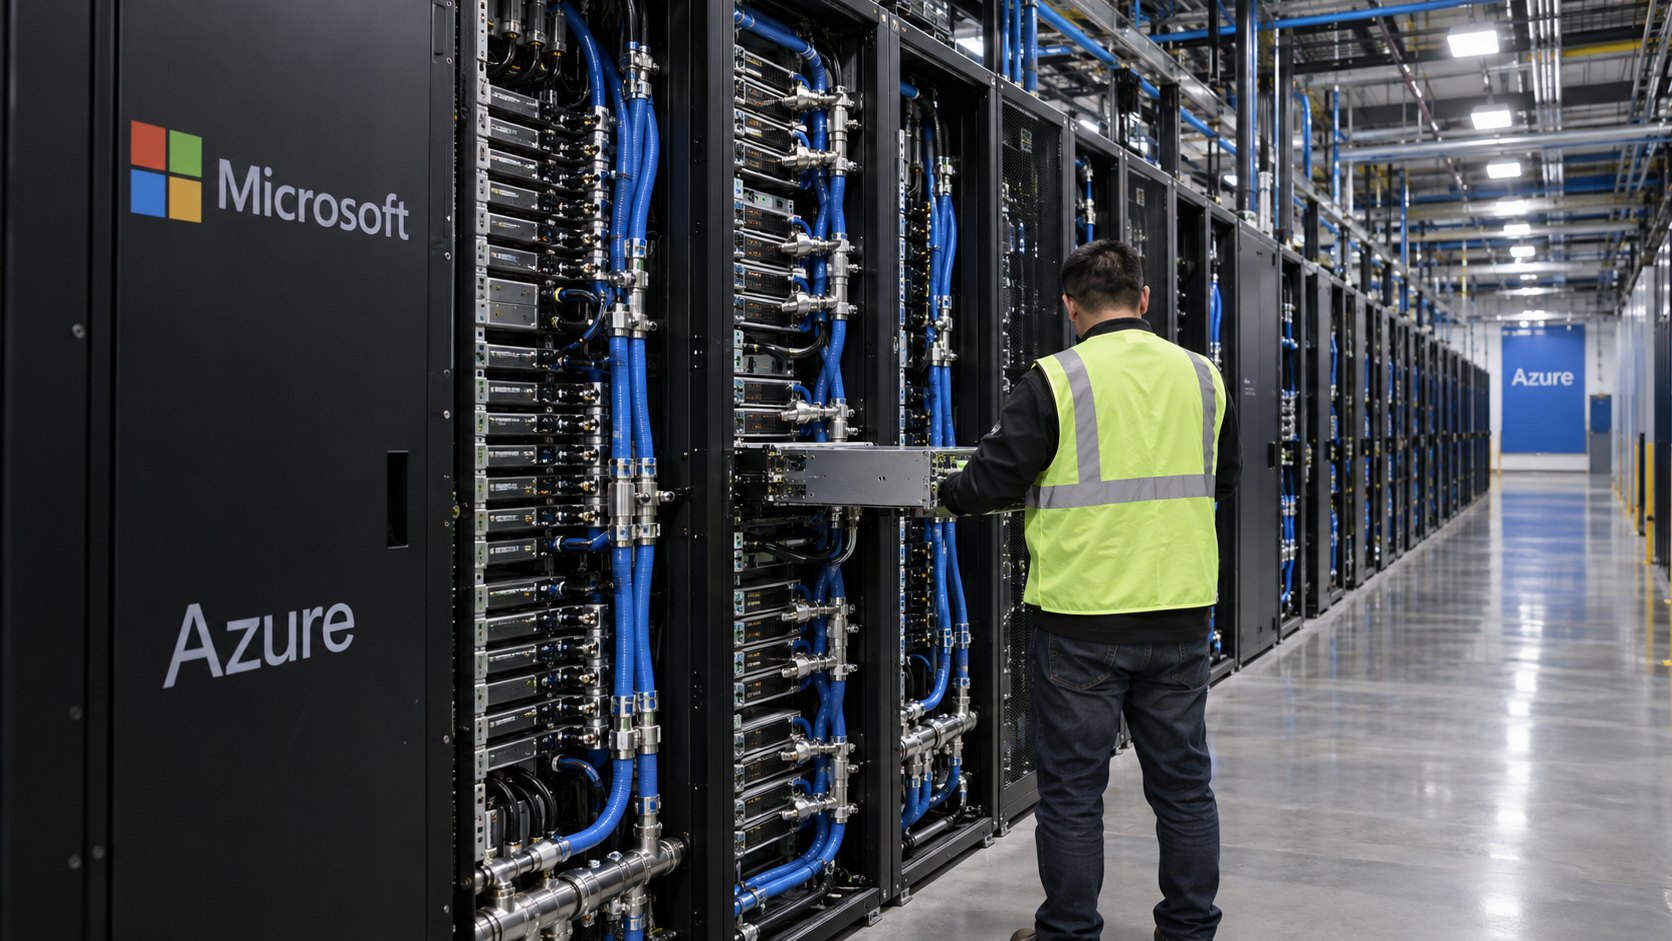
La compañía afirma que el nuevo acelerador, con chiplets de cómputo fabricados por TSMC en 2 nanómetros, entregará 40% más tokens por megavatio que los principales sistemas basados en GPU. La generación anterior, Maia 200, ya atiende a Copilot y corre modelos de OpenAI; según Reuters, Microsoft podría instalar más de un millón de Maia 300 el año próximo.
Microsoft anunció este lunes 12 de octubre Maia 300, la tercera generación de su acelerador propio para inteligencia artificial, y dijo que llevará la familia Maia a despliegues de «varios gigavatios» a partir de 2027, cuando pasará a ser «el sistema principal de inferencia» de sus productos y servicios. El anuncio lo firmó Scott Guthrie, vicepresidente ejecutivo de Cloud + AI, en el blog oficial de la compañía.
Según Microsoft, Maia 300 entregará 40% más tokens por megavatio que «los principales sistemas basados en GPU» —no precisó con cuáles se comparó— y, en una configuración completa de 96 aceleradores, hasta siete veces el rendimiento de tokens por rack de Maia 200. Los despliegues de producción empezarán en 2027. Reuters informó que la empresa podría instalar potencialmente más de un millón de chips Maia 300 el año próximo para sus servicios internos de IA.
Qué trae el chip
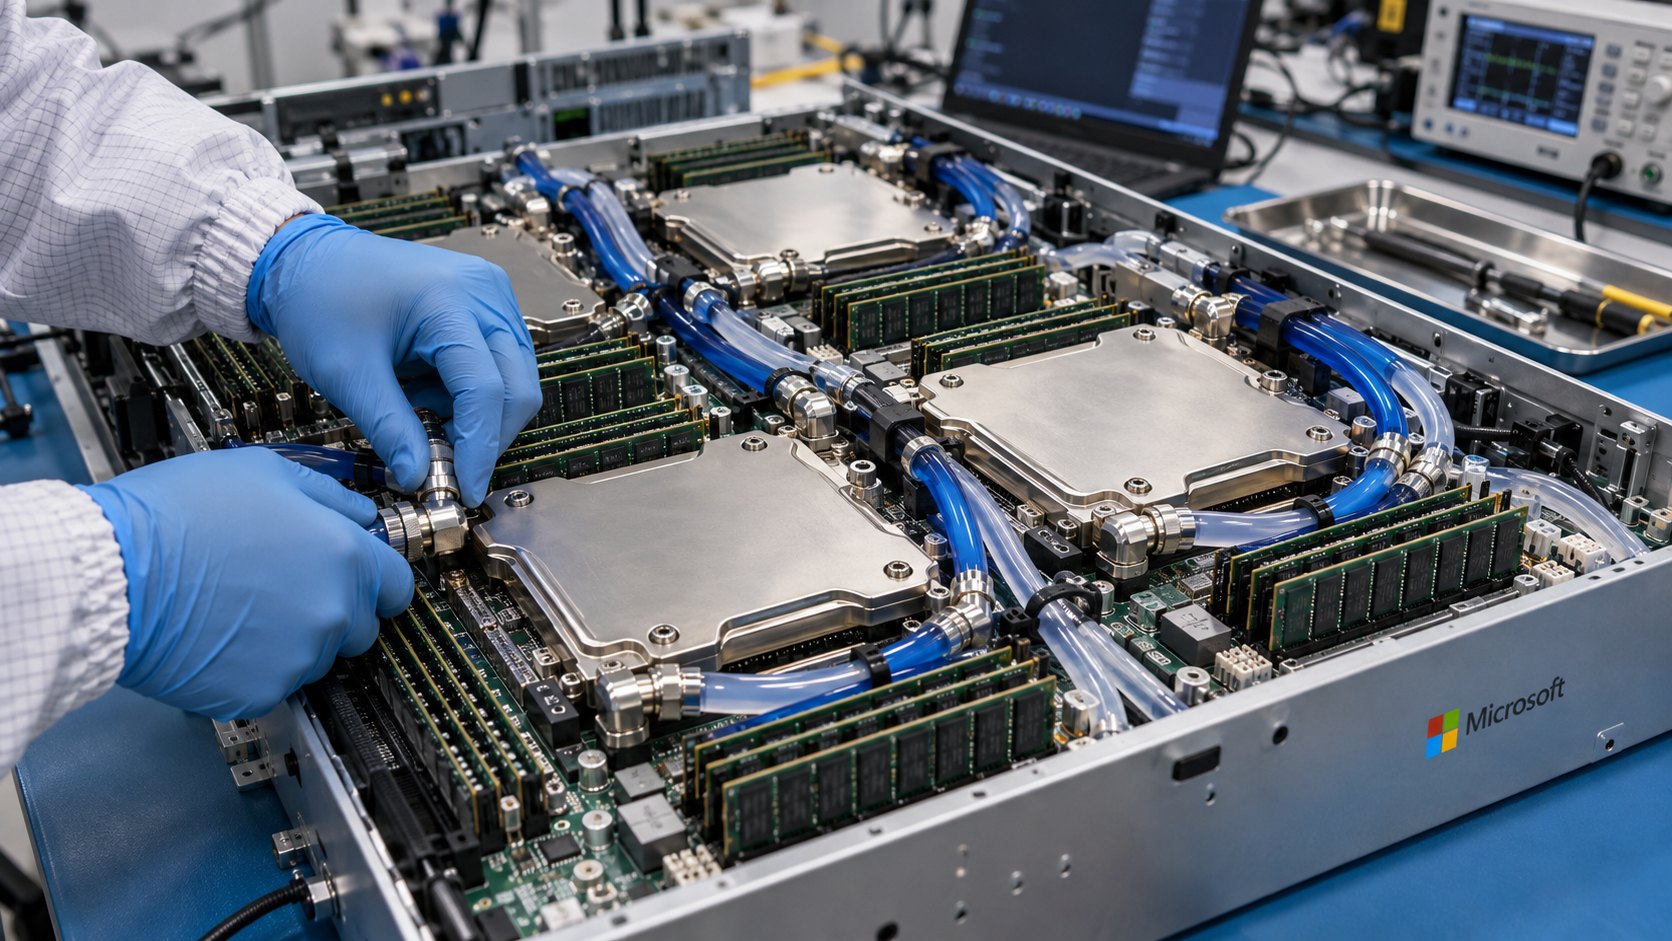
Maia 300 está diseñado ante todo para la inferencia —ejecutar modelos ya entrenados—, en particular para razonamiento con contextos largos, conversaciones sensibles a la latencia y agentes que trabajan en varios pasos. En lugar de un único chip de cómputo grande, usa una arquitectura de chiplets: los de cómputo se fabrican con el proceso N2P de TSMC (2 nanómetros) y las funciones de control de memoria y de entrada/salida quedan en piezas separadas, que según Reuters usan una tecnología más barata de 3 nanómetros.
Cada acelerador lleva ocho pilas de memoria HBM4 con 288 GB y 18 TB/s de ancho de banda pico, dentro de un consumo de diseño de 950 vatios. Un rack reúne 96 aceleradores en 167 kilovatios, con 27,6 TB de HBM, y la red de interconexión, basada en Ethernet, escala hasta 128 racks y 12.288 aceleradores, según el documento técnico de Azure. Como referencia, Reuters señaló que los racks GB300 más recientes de Nvidia alojan 72 GPU y consumen unos 142 kilovatios.
Dónde ya funciona Maia 200
La generación anterior, Maia 200, presentada en enero, ya atiende cargas de producción de Microsoft, incluido Microsoft Copilot, y respalda al equipo MAI que desarrolla los modelos propios de la compañía; GitHub Copilot y Microsoft Foundry la sumarán antes de fin de año. Corre modelos de OpenAI, los modelos MAI y familias de código abierto, y se está desplegando en Estados Unidos, Europa y Australia. Microsoft sostiene que entrega hasta 1,7 veces más tokens por vatio que la infraestructura GPU líder en las funciones de IA integradas en Teams, Copilot y Cowork.
«Básicamente está entregando más inteligencia por cada vatio, por cada dólar», dijo a Reuters Rani Borkar, presidenta de sistemas de hardware e infraestructura de Azure.
Por qué importa
El anuncio se suma a la ola de chips propios de las grandes nubes y de empresas de IA como OpenAI, que buscan reducir la dependencia de Nvidia, dominante en el cómputo para IA. Para Microsoft, que según Reuters prevé invertir más de US$ 175.000 millones en bienes de capital este año calendario, el costo de energía y de hardware por cada respuesta generada pasó a ser una variable central: la propia empresa resume su objetivo como más «tokens útiles por vatio y por dólar».
Las cifras de rendimiento son de Microsoft y no tienen verificación independiente. Qué sigue: la compañía prometió más detalles en Microsoft Ignite 2026, el mes próximo en San Francisco, y el inicio de los despliegues de producción de Maia 300 en 2027.
Fuentes: Microsoft (blog oficial, Scott Guthrie), Azure (arquitectura de Maia 300), Reuters, CNBC.
Comentarios
Participá con respeto. Los comentarios se publican al enviarlos.